 Юрий Летков
Сразу с места в карьер, без всяких прелюдий. В основе «Сокола-2», как и первого «Сокола», лежит пермутационный тест. Во втором — пермутационный тест на равенство средних. Идея его такая: если разницы в реагировании на Пв и Вл нет, то как ни обозначай данные теста, какую метку ни присваивай — Пв или Вл, для определения того, на какой тип сильнее реагирование, ничего не изменится. То есть в этом случае можно менять метки вопросов как угодно, сохраняя при этом общее количество Пв и Вл стимулов. Можно метки переставлять и каждый раз вычислять средние по группам Пв и Вл.
Как работает пермутационный тест — на пальцах
Представьте: у вас 18 карточек — 9 с пометкой «Пв» и 9 с пометкой «Вл». На каждой карточке четыре числа (реакции по четырём каналам). Вы раскладываете их на две стопки по меткам и считаете средние в каждой стопке. Получаете разность средних.
Теперь — ключевой шаг. Вы снимаете все метки, перемешиваете 18 карточек и заново делите на две случайные стопки по 9. Снова считаете разность средних. И так — тысячи раз.
Получается гора «случайных» разностей — это и есть пермутационное распределение. Оно показывает, какие разности вообще возможны, если Пв и Вл в среднем не отличаются (а различия — чистая случайность).
Осталось посмотреть, куда попала ваша настоящая разность. Если она затесалась где-то в середине горы — значит, такая разность легко возникает случайно, и оснований говорить о реальном различии нет. А если она торчит с самого края — значит, случай такое не организует, и различие настоящее.
Что происходит «под капотом»
- Считаем наблюдаемую разность средних (Пв − Вл) для каждой переменной.
- Объединяем все четыре разности в одну общую статистику (чтобы решить задачу по всем переменным сразу).
- Перемешиваем метки Пв/Вл — например, 100 000 раз — и каждый раз пересчитываем ту же статистику.
- Смотрим, какая доля случайных значений статистики оказалась не меньше наблюдаемой. Это и есть p-значение.
Никаких предположений о нормальности, равенстве дисперсий или независимости между каналами. Распределение строится из самих данных, а не берётся из готовой таблицы.
Смотрим на данные теста из второй части, на результат их анализа в пермутационном тесте.
Ниже представлены результаты многомерного пермутационного теста.
| Физиологический канал | Направление z-оценки | Значение z | Статус |
|---|---|---|---|
| Дыхание | В сторону «Ложь» | +0.1359 | ✓ |
| КГР (ЭДА) | В сторону «Правда» | -0.7703 | ✗ |
| ПГ (Плетизмо) | В сторону «Правда» | -0.4170 | ✗ |
| АД (Манжета) | В сторону «Правда» | -0.9288 | ✗ |
| Сумма (T) | В сторону «Правда» | -1.9802 | — |
z-оценка — стандартизованная разность средних, показывающая направление и величину эффекта в каждом канале
Глобальный односторонний тест (гипотеза «Пв > Вл по всем каналам одновременно»): p ≈ 0,9938.
Гипотеза не подтверждается — и это мягко сказано. По трём каналам из четырёх средние Пв не больше, а меньше средних Вл. Наблюдаемая статистика оказалась не на правом краю распределения (где она должна была бы быть для подтверждения «Пв > Вл»), а почти на левом — то есть результат смотрит в противоположную сторону.
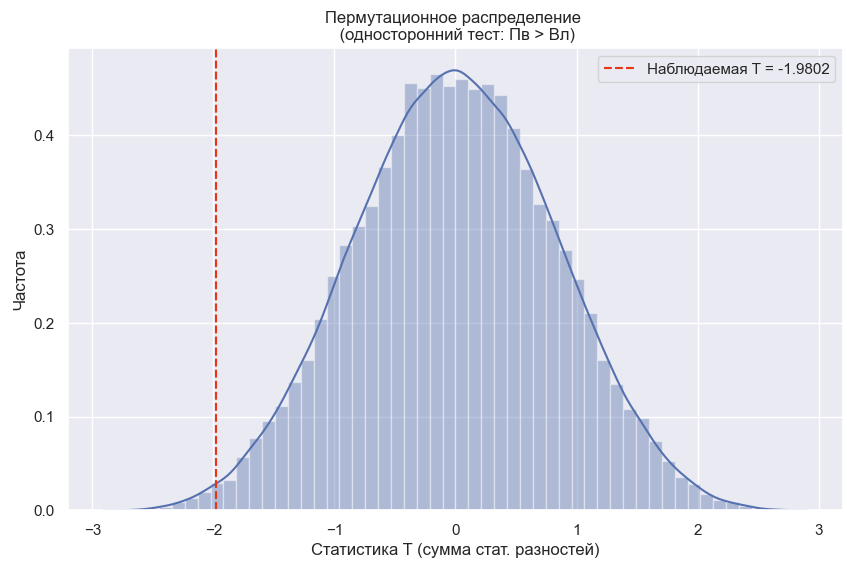
Наблюдаемая статистика T отмечена пунктирной вертикальной линией. Подавляющее большинство разностей лежит правее вертикальной линии — они больше наблюдаемой T. Если площадь «колокола» принять за единицу, то площадь, отсекаемая от колокола пунктирной линией справа, равна 0,9938. Это и есть p-значение, полученное в проведённом тесте. Таким образом, гипотезу о том, что средние группы Пв больше среднего группы Вл, решительно не принимаем. Мы можем принять гипотезу о том, что Вл > Пв. P-значение для этой гипотезы — это площадь «хвостика» колокола слева от вертикальной пунктирной линии. 1 — 0,9938 = 0,0062.
- Гипотеза 1 (Пв сильнее Вл): p = 0,9938 — это правосторонняя гипотеза.
- Гипотеза 2 (Вл сильнее Пв): p = 0,0062 — это левосторонняя гипотеза.
Достоинства пермутационного теста
1. Не требует нормальности. t-тест не прошёл по КГР — распределение явно ненормальное. Пермутационный тест на это просто не смотрит: он строит распределение из данных, а не из формулы.
-
Не требует независимости между каналами. Метод Фишера предполагает, что p-значения из разных тестов независимы. Но дыхание, КГР, ПГ и АД измерены на одном человеке — они коррелированы. Многомерный пермутационный тест обходит это: при каждом перемешивании все четыре канала двигаются вместе, как единый блок. Корреляция сохраняется и в наблюдаемых данных, и в случайных перестановках — и потому не искажает результат.
-
Работает на малых выборках. 9 наблюдений в группе — это немного. Параметрические тесты на таких данных чувствительны к нарушениям допущений. Пермутационный тест — нет, потому что он не опирается на асимптотические приближения.
-
Точные p-значения. При достаточном числе перестановок p-значение получается точным, а не приближённым. Не нужно доверять «достаточно ли велика выборка, чтобы тест сработал».
-
Понятная логика. Идея «перемешать метки и посмотреть, что могло бы случиться» интуитивно ясна даже без статистического образования. Это важно для полиграфолога, который должен понимать, откуда берётся решение.
Таким образом, если мы в результате пермутационного теста получаем p-значение менее 0,05, то принимаем гипотезу о том, что Пв > Вл, что означает в рамках принятого нами исходного положения во второй части, что проверяемый сильнее реагировал на проверочные стимулы в тесте. Если (1 — p-значение) < 0,05, то реагирование проверяемого на Вл статистически значимо превышает его реагирование на Пв.
Такой способ принятия решения является научно и практически обоснованным. Именно так проверяют гипотезы в науке.
Можно было бы считать алгоритм законченным, и он бы заключался всего лишь в применении статистического теста. Но дело в том, что используемые в тесте данные малы. В таких условиях статистические тесты обладают небольшой мощностью. То есть, p-значение будет нечасто принимать значение меньше 0,05 и больше 0,95. Оценка на реальных данных показала, что это происходит только примерно в 40% случаев. Остальными 60% — p-значений болтаются где-то между 0,05 и 0,95, и решение не принимается. Для повышения мощности теста надо увеличивать количество данных, иначе говоря, увеличивать количество повторов теста. Но насколько это возможно сделать без того, что состояние проверяемого поменяется — не произойдёт привыкание, рассеятся внимание, наступит усталость и т. п., в результате чего данные будут искажены, не известно. Этот вопрос не изучен.
Но выход из положения есть. И тут мы переходим ко второй части алгоритма — к байесовскому анализу данных теста.
Для этого были изучены распределения натурального логарифма отношения p-значения к (1 — p-значение). В статистике p/(1 — p) называется шансами
. Конкретно для нашего случая это шансы того, что при верности нулевой гипотезы статистика теста примет наблюдаемое или меньшее значение. То есть, шансы p-значения для левосторонней гипотезы.
На выборке из ста тестов с известным решением Института полиграфологии Министерства обороны США (DoDPI), в которую входит 50 тестов с независимым подтверждением сокрытия информации, 50 с независимым подтверждением отсутствия сокрытия, были изготовлены калибровочные распределения отношения шансов. В каждом случае посчитали натуральный логарифм отношения p-значения левостороннего к p-значению правостороннего. Получили две выборки по 50 элементов со значениями натуральных логарифмов. Удалили из них выбросы. Построили гистограммы. Диаграммы qq-плотов. Провели тесты Шапиро-Уилка. P-значения получились 0.4211 и 0.8571. Построили теоретические нормальные распределения с оценками параметров, оценённых по выборкам. И теперь, используя априорную вероятность, по формуле Байеса можно вычислять оценку вероятности того, что человек скрывает информацию по теме проверки.
Исходные гистограммы калибровочных выборок.
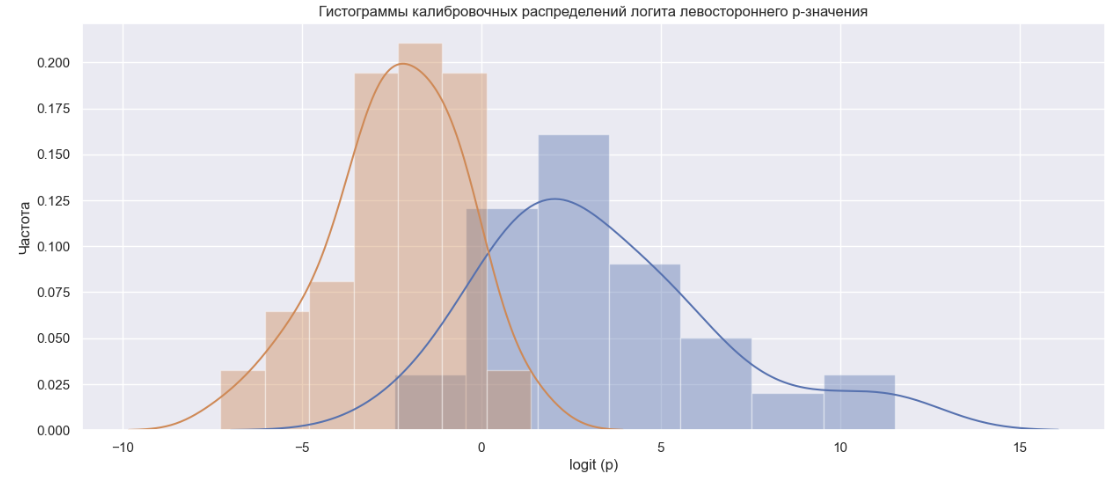
После удаления выбросов из калибровочных распределений в группе "Ложь" осталось 47 элементов, в группе "правда" 46. Выбросы удалялись на основе межквартильного размаха. Далее были построены диаграммы q-q-плот и проведены тесты Шапиро-Уилка на нормальность распределений.
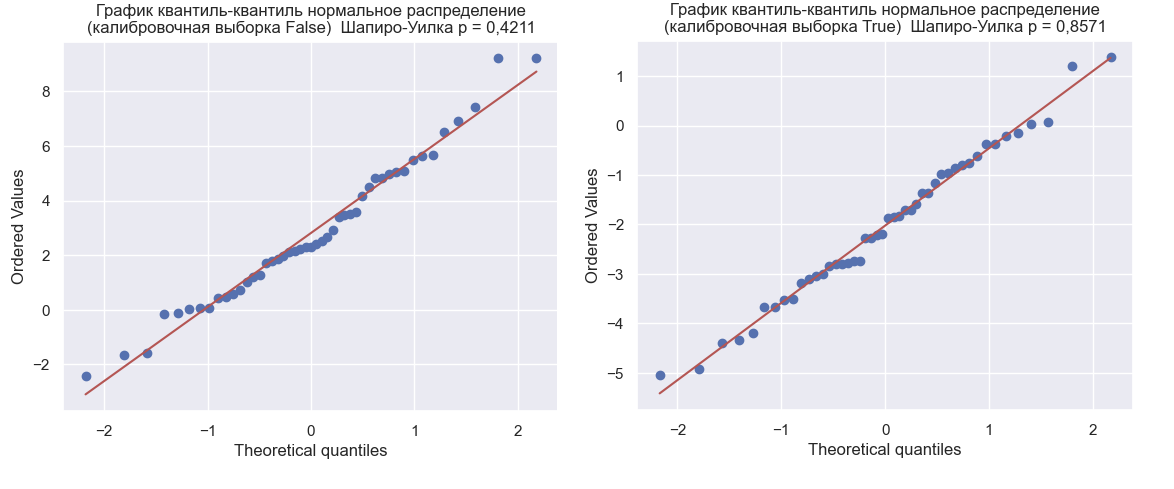
Таким образом стало возможно не использовать ядерную оценку плотности (что вызвало бы у полиграфологов дополнительные затруднения для понимания как работает алгоритм ), а использовать теоретические нормальные распределения для калибровочных распределений.
И теперь с помощью теоремы Байеса имеется возможность дать оценку вероятности того к какому профилю реагирования принадлежит реагирование тестируемого лица. Касаться сути теоремы Байеса и его формулу мы не будем. Мы визуально поймём, что происходит, и как это всё делается, откуда берётся вывод. Сделаем на примере данных теста, которые мы видели во второй части. Помним, что наблюдаемая статистика теста Т = -1,9802, а наблюдаемый логарифм шансов (логит) равен Ln((1 - 0,9938)/0,9938) = -5,069
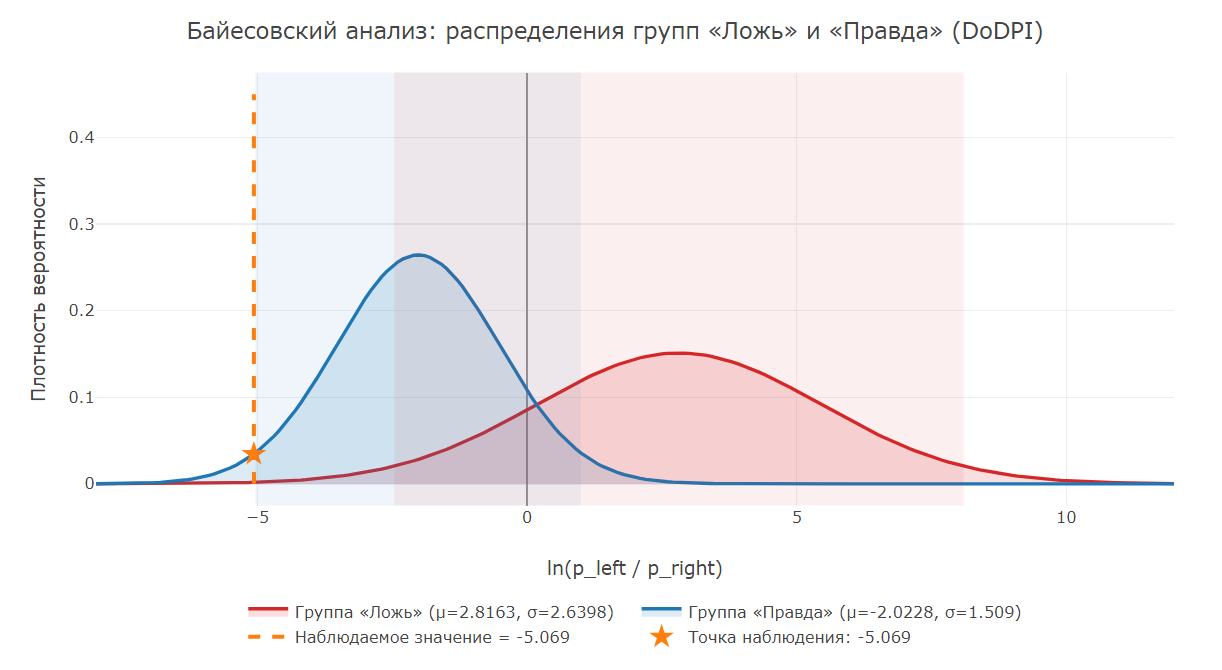 Слева имеем колокол нормального распределения группы не скрывавших информацию по проверочной теме, а справа — скрывавших. Их колокола всегда перекрываются, и поэтому всегда существует отличная от нуля вероятность, что профиль реагирования тестируемого принадлежит не к первой группе, а ко второй. И принять решение надо на основе оценки этой вероятности. Можно по этой визуализации принять качественное решение. Например, так: наблюдаемое значение логита (оранжевая пунктирная вертикальная линия) находится существенно дальше от центра распределения группы «Ложь», чем от центра группы «Правда». Отсюда вывод — профиль реагирования тестируемого, согласно калибровочным распределениям, соответствует профилю реагирования людей, отвечавших правду на проверочные вопросы. И так же объяснять принимаемое решение, если наблюдаемый логит находится справа от центров калибровочных распределений.
А как же численно выразить нашу уверенность? Оценка вероятности вычисляется по формуле Байеса, в которую входят априорные вероятности. На практике они всегда неизвестны и принимаются за 0,5 (что недалеко от истинного значения). Но в таком случае в формуле Байеса априорные вероятности сокращаются, и формула упрощается. Ниже с помощью рисунка показано, как вычисляется вероятность того, что профиль реагирования принадлежит группе «Ложь».
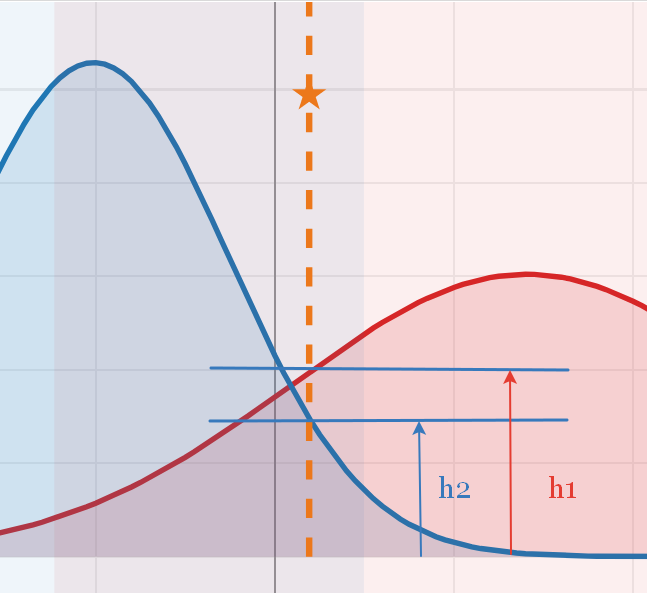
Вероятность принадлежности профиля к группе «Ложь» P = h1/(h1 + h2).
Словами: расстояние от оси х до «колокола» группы «Ложь», делённое на сумму расстояний до колоколов группы «Ложь» и группы «Правда».
Более научно это звучит так: h1 и h2 — это значения плотностей вероятностей калибровочных распределений "Ложь" и "Правда" в точке наблюдаемого логита. Геометрически это высота кривой в данной точке.
На основе полученной оценки вероятности можно принимать решение. Пороги выбраны на основе оценки баланса между ошибками первого и второго рода на калибровочных данных. Если принимать решение при P>0,5 то на калибровочных данных 89 профилей тестируемых определены правильно, в 11 случаях допущена ошибка (всего 100 тестов). Рекомендуется принимать решение при P>0,7. В этом случае на калибровочных данных 80% правильных решений, 7% ошибочных и 13% неопределённых исходов. При при P>0,9 решение можно принимать более уверенно. Результат на этой выборке примерно (плюс-минус) такой же как у известных американских алгоритмов. Но зато "Сокол2" полностью открытый, объяснимый и интерпретируемый алгоритм. Если необходима большая точность — добро пожаловать к другим алгоритмам СППРП "Сокол", но они не столь просты для понимания и интерпретации.
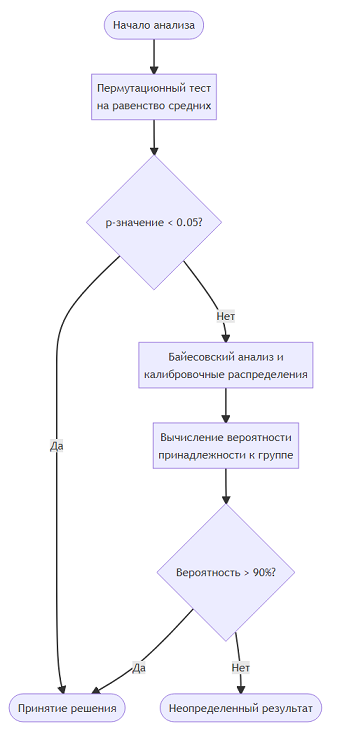
В итоге имеем два этапа работы алгоритма:
- Пермутационный тест на равенство средних. Если p-значение односторонней гипотезы менее 0,05 — принимаем решение. Иначе следующий пункт.
- На основе байесовского анализа и калибровочных распределений вычисляем оценку вероятности принадлежности профиля реагирования к той или иной группе. Если полученная более 70% — принимаем решение. Иначе неопределённый результат
В СППРП «Сокол» с помощью выбранной нейронной сети подготавливается автоматический отчёт, в котором все этапы работы алгоритма объясняются, данные интерпретируются и указывается, на основании чего принимается решение. Тут можно скачать его для ознакомления.
В конце отчёта всегда будет вот такой подобный параграф:
Примечание:
Вероятнее всего, человек скрывает информацию по теме проверки (так как вероятность этого > 0,9).
Эта вероятность не означает абсолютного доказательства правдивости/обмана. Она является статистической оценкой, зависящей от качества полиграфного обследования, корректности измерений показателей и обработки выбросов, применимости калибровочных распределений DoDPI и отсутствия существенных внешних факторов, влияющих на физиологические реакции.
Все пункты, кроме применимости калибровочных распределений DoDPI, должны обеспечиваться полиграфологом и являются его зоной ответственности.
И помните, что алгоритм — это только алгоритм, а всё остальное — это зона ответственности полиграфолога.