 Юрий Летков
В первой части мы с вами поговорили о кнопке «Стьюдент» в «Диане». Пытались выяснить, что она делает, и у нас это не получилось. Зато мы познакомились с t-понятиями. В частности, познакомились с t-тестом и, благодаря ему, с тем, что такое статистический тест в общем. Как он работает и с чем его «едят». Последнее особенно важно для нас, так как в дальнейшем мы познакомимся с вами с ещё одним статистическим тестом, который просто идеально подходит для метрических данных полиграфного теста. Но тут я забегаю вперёд. Для того чтобы понять, что именно этот тест подходит, нам надо хорошенько разобраться в том, что из себя представляют метрические данные теста МКВ. Вообще говоря, мысль сделать полностью открытый экспертный алгоритм мне пришла после того, как в дискуссиях полиграфологов прозвучало, что алгоритм — это чёрный ящик. Если подумать, то алгоритм может быть чёрным ящиком в двух случаях:
- Разработчик объявил его содержание коммерческой тайной. И на этом основании не сообщает об алгоритме никакой верифицируемой информации, за исключением, быть может, каких-нибудь рекламных материалов, а то и откровенных басен (никого конкретно не имею в виду);
- Материалы по алгоритму представлены, но пользователь по каким-то причинам не желает в них разбираться.
Если с первым случаем всё ясно и обсуждать тут нечего, то со вторым не всё так однозначно. Объявлять в этом случае алгоритм «чёрным ящиком» просто нечестно. Да, для пользователя он таковым является, но только потому, что он не прилагает усилий к тому, чтобы разобраться в работе алгоритма. И разобраться не на уровне человека с достаточной математической подготовкой, а на уровне уверенного пользователя, имеющего определённую математическую культуру в силу своего образования и/или своей любознательности и профессиональной обязательности. На научно-популярном уровне, в общих, но верных чертах, можно понять работу любого алгоритма. Достаточно только усвоить основные понятия. Что мы и делали в первой части.
Итак, приступим к анализу данных. Возьмём данные теста, диановские гистограммы которого были в первой части. Это тест ЮТА с ВВЛ 3Пв. Предварительно с помощью алгоритма поиска выбросов СППРП «Сокол» заменим обнаруженные выбросы на медианные значения. Также на медианные значения заменим те стимулы, которые были помечены полиграфологом как «артефактные».
№;Тип;Дыхание;КГР;ПГ;АД
1;Вл1;209.5;30.6;91.8;497.9
2;Пв1;217.4;17.4;92.0;125.9
3;Вл2;204.0;6.55;89.15;357.45
4;Пв2;229.4;4.6;89.8;179.9
5;Вл3;243.4;12.1;77.6;455.1
6;Пв3;204.9;7.1;90.4;322.8
7;Вл2;190.5;21.6;92.0;419.1
8;Пв3;200.7;1.9;81.7;0.0
9;Вл3;179.7;5.6;84.6;120.0
10;Пв1;195.3;0.7;100.2;354.8
11;Вл1;212.0;6.9;96.9;295.8
12;Пв2;197.2;8.5;92.6;120.4
13;Вл3;202.9;4.1;88.0;113.1
14;Пв2;199.4;0.4;90.9;165.4
15;Вл1;201.6;3.9;88.3;555.2
16;Пв3;197.9;0.5;92.0;249.1
17;Вл2;205.1;6.2;90.0;155.2
18;Пв1;188.5;0.1;87.8;140.1
Имеем вот такую табличку с данными. Опишем её словесно, привычным для полиграфологов языком. Имеем 4 группы показателей реакции в четырёх физиологических каналах: Дыхание, КГР, ПГ, АД. Каждая из этих групп разделяется на две: группа Пв и группа Вл. Итого имеем четыре сравниваемых пары. Наша задача состоит в том, чтобы определить, на какой из двух стимулов проверяемый реагирует сильнее.
Исходное положение: принимаем, что сильнее реагирование на тот стимул, среднее значение показателя которого больше.
Казалось бы, что это просто. Но далеко не в каждом случае. У нас 4 группы показателей. А что, если в двух из них средние показатели Пв больше средних Кв, а в остальных двух наоборот Кв > Пв? Как нам тогда прийти к общему знаменателю и принять решение? А может быть так, что в трёх группах имеется согласованная разница (в одном направлении), а в четвёртом в противоположном, но в первых трёх она относительно небольшая, а в четвёртом очень сильная. Помимо этого мы не можем основываться на непосредственных значениях средних, так как мы имеем дело со случайными величинами, а значит со статистикой. Мы должны показать, что разница между средними не только имеет место (а она практически всегда будет иметь место), но является статистически значимой. Статистическая значимость означает, что мы не можем отмахнуться от наблюдаемой разницы, сказав, что на самом деле её нет, а то, что мы видим, это всего лишь дело его величества случая.
Ответом сказанному выше может быть использование t-теста. Он покажет, статистически значима ли разница в каждой из групп. Проведя его в отдельности для каждой из 4 групп, мы получим четыре p-значения. Всё будет замечательно, если все p<0.05, а наблюдаемая разница средних во всех группах имеет один знак (в одном направлении), например, во всех группах показателей Вл > Пв. Ну, казалось бы, очевидный случай. Но опять-таки такие очевидные случаи бывают нечасто, практически на идеальных полиграммах. А если наблюдаемые эффекты (наблюдаемая разница средних) вразнобой (разные знаки), да ещё величина эффектов разная, p-значения и меньше и больше? В статистике разработаны методы, позволяющие свести результаты множественных сравнений к одному. Например, четыре p-значения для принятия решения можно свести к одному, воспользовавшись методом Фишера, который позволяет объединить несколько независимых p-значений в единую статистическую значимость. Или использовать поправку Бонферрони на множественные сравнения.
Но опять-таки, чтобы корректно воспользоваться методом Фишера (как и любым другим), необходимо учитывать ограничения, накладываемые на данные для использования метода Фишера. А поправка Бонферрони, которая в нашем случае переведёт значение α из 0,05 в 0,0125 (ужесточает порог значимости, деля α на число сравнений), обладает маленькой мощностью (способность обнаружить эффект, когда он действительно есть).
Итак, что нам надо проверить для корректного использования t-теста, учитывая, что выбросы мы уже удалили:
- Нормальность распределения в каждой группе Пв и Вл для каждого канала. Ни в одном канале не должно быть отклонения от нормальности;
- Необходимо проверить равенство дисперсий, для того чтобы определится с видом t-теста;
Для метода Фишера объединений p-значений необходимо независимость p-значений, необходимо, чтобы они были получены в разных из независимых тестов. Но так как все данные сняты на одном человеке, вряд ли условие независимости будет соблюдаться. Надо искать более сложные методы объединения p-значений. Но мы спешить с этим не будем, так как нас ждёт впереди более простое решение.
Анализируем наши данные.
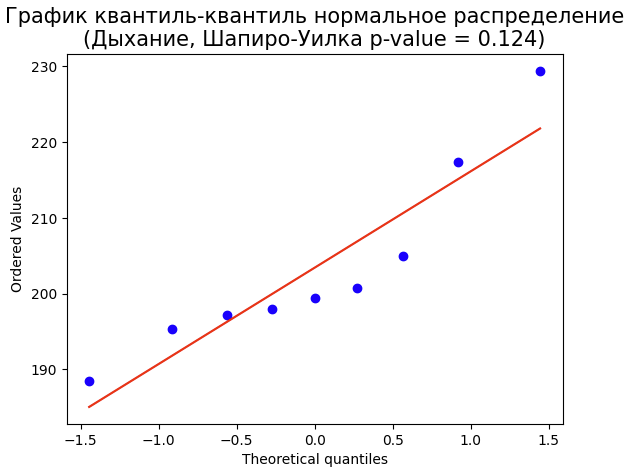
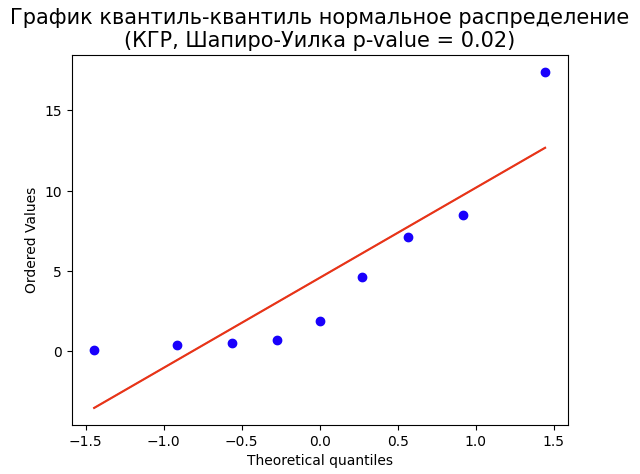
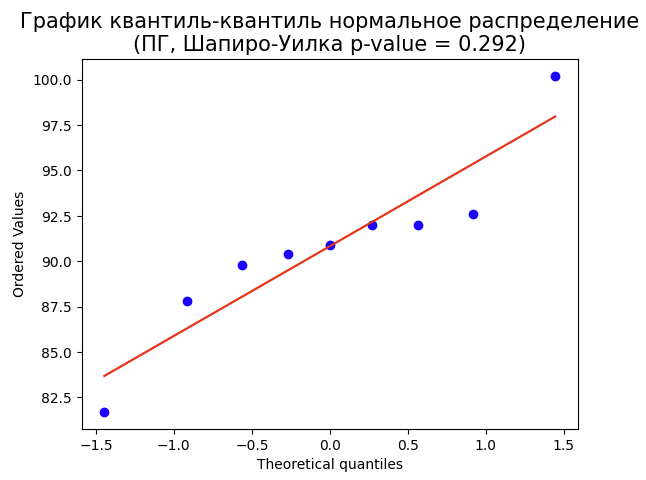
Группа Пв стимулов
Группа Вл стимулов
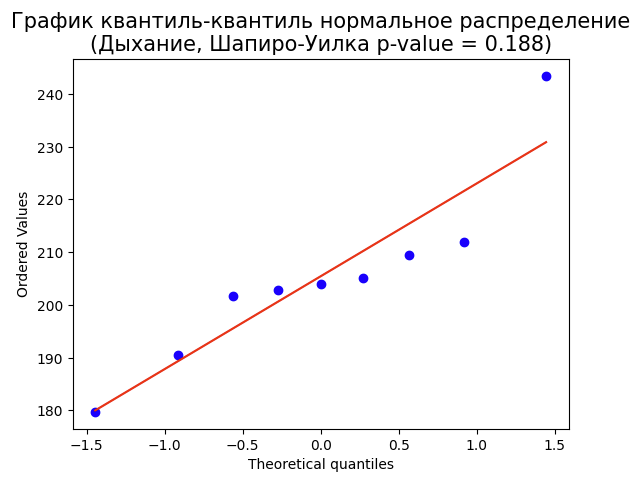
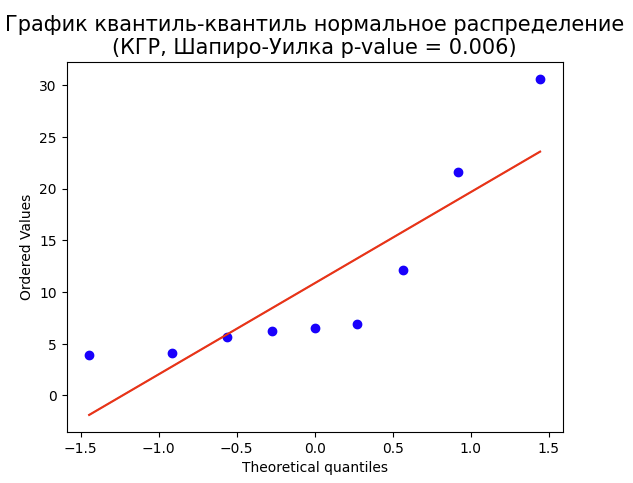
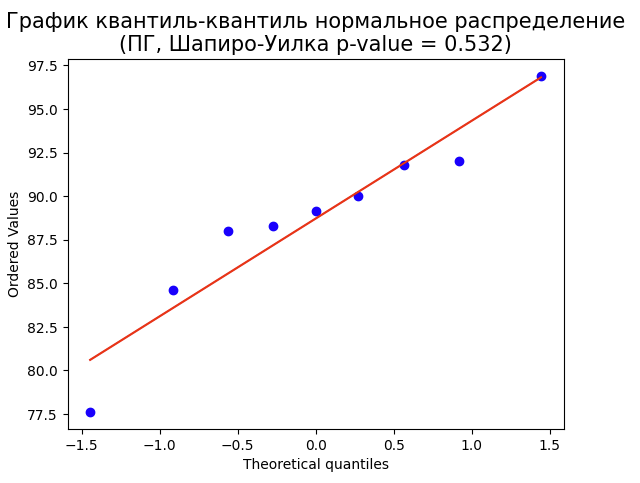
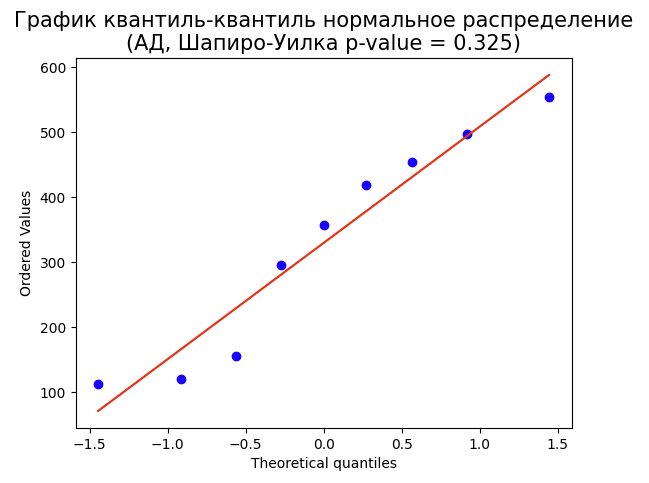
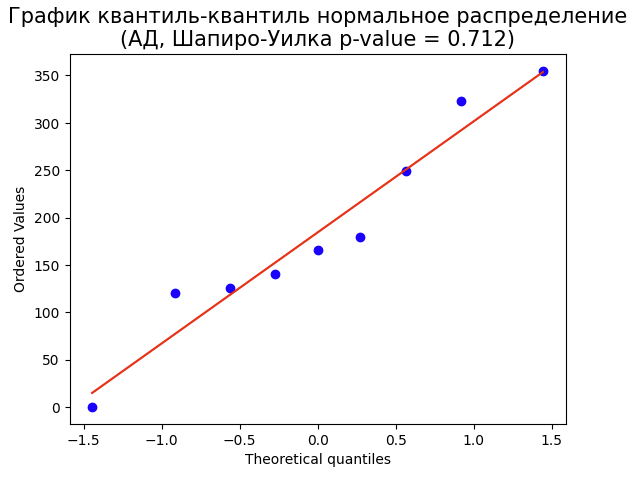
КГР не проходит тест Шапиро-Уилка на нормальность. В группе Пв p-value = 0.02, в группе Вл p-value = 0.006. Остальные каналы в обеих группах тест проходят, но это не означает, что их распределения точно подчиняются нормальному закону. Вероятнее всего, эффект мал (отклонение от нормальности) и мощности теста Шапиро-Уилка, из-за малости выборки, не хватает данных, чтобы его обнаружить. В КГР же эффект ярко выражен и легко обнаруживается на малой выборке. И этого уже достаточно, чтобы признать применение t-теста некорректным. t-статистика опирается на распределение средних, а при малой выборке и ненормальности это распределение «плывёт и ломается». Ну, раз мы назвали себя экспертами, то, видимо, должны всё делать максимально корректно. Тогда давайте ещё посмотрим на корреляцию наших данных.
Попросим СППРП «Сокол» посчитать корреляции и построить диаграммы рассеяния.
Группа Пв стимулов
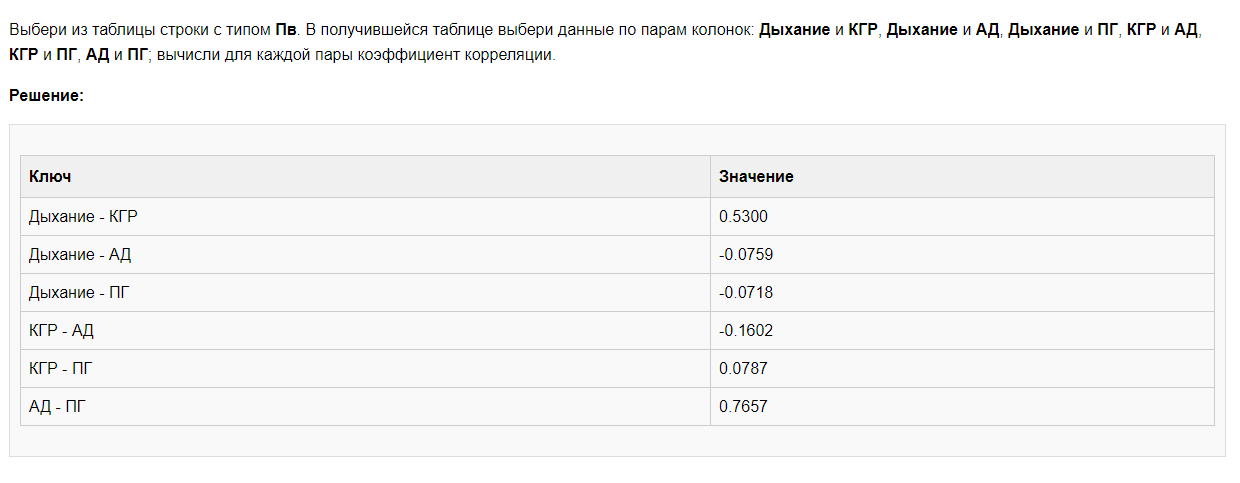
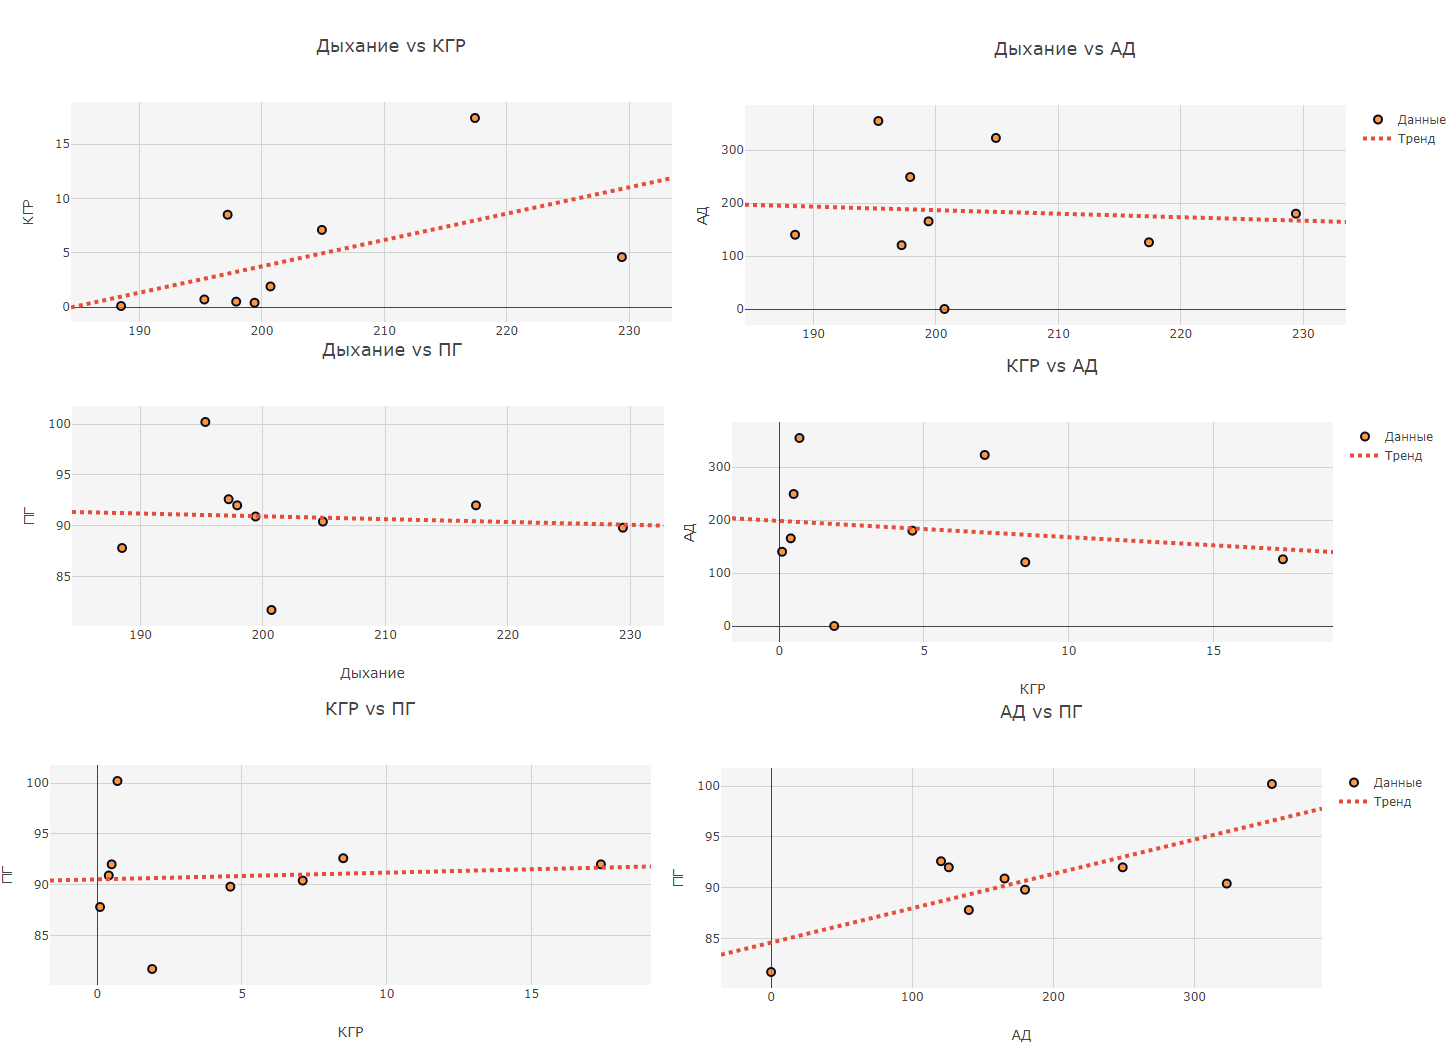
Как можно видеть, в группе Пв наблюдается сильная достаточно сильная корреляция показателей АД и ПГ, КГР и Дыхание. И это довольно-таки интересно само по себе, поскольку мы видим положительную корреляцию, а она в данном случае означает, что чем сильнее, например, реакция по КГР, тем слабее реакция по дыханию; чем сильнее реакция в АД, тем слабее реакция в ПГ. Это из-за того, что в КГР и АД реакция тем сильнее, чем больше показатель, а в Дыхании и ПГ (в данном случае ПО «Диана») чем меньше показатель, тем сильнее реакция.
Но раз мы видим сильную корреляцию, хотя бы в части каналов, использовать метод Фишера для объединения p-значений некорректно. Метод Фишера предполагает, что p-значения получены из независимых тестов, а у нас каналы коррелированы — стало быть, p-значения тоже зависимы
Группа Вл стимулов
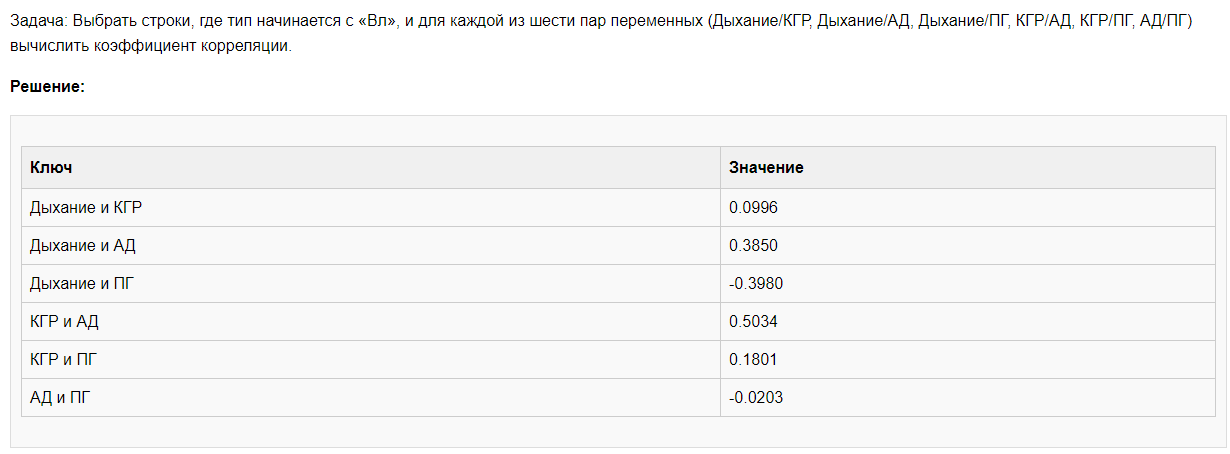
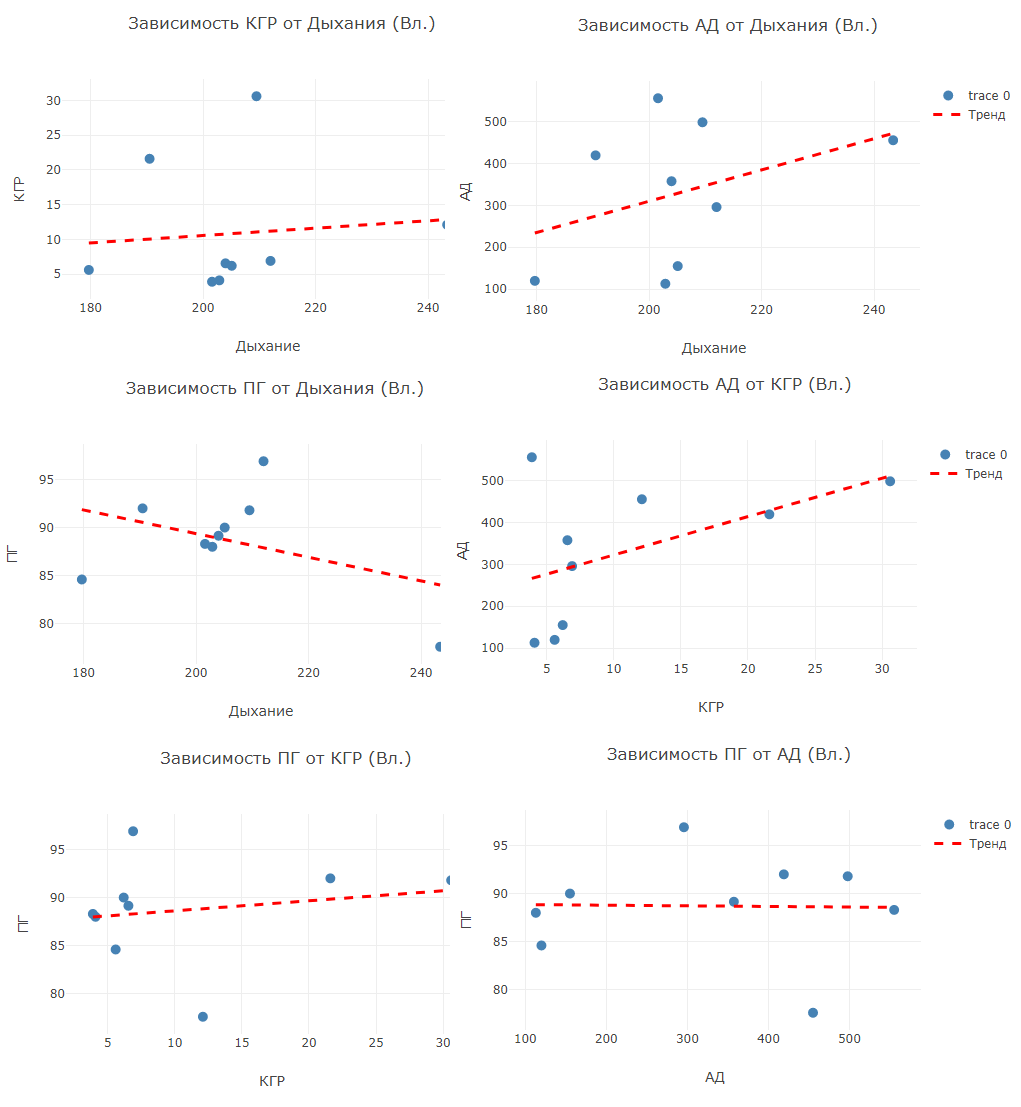
В группе Вл видим сильные корреляции КГР и АД, Дыхания и АД, Дыхания и ПГ.
Данные проходят тесты на равенство дисперсий в группах Пв и Вл по всем каналам, статситически значимой разницы между дисперсиями не обнаруживается. Но это роли уже не играет. От разницы в дисперсиях, при прочих выполняющихся условий, зависит только, выбор теста Стьюдента или Уэлча.
Итог
В результате проделанного анализа имеем, что данные теста имеют отклонение от нормального распределения (в части КГР почти наверняка), данные по различным каналам коррелируют с различной степенью корреляции. Что и не удивительно — данные сняты в ходе одного теста, проведённого с одним человеком. Как эксперты-полиграфологи мы должны отказаться от использования t-теста и метода Фишера.
Но, как говорится, на Стьюденте статистический свет клином не сошёлся. Существуют методы численного ресеплинга, Монте-Карло, на основе которых разработаны пермутационные (перестановочные) тесты, которые обладают замечательными свойствами, просто-таки созданы для анализа данных полиграфного теста. Они решают все проблемы с данными одним махом. А как это делается, мы увидим с вами в третей части, и наконец-то узреем полностью, как работает экспертный алгоритм «Сок2ол».
Для тех, кто хочет освежить терминологию перед третьей частью.
Справочная информация
Методы численного ресеплинга
Ресемплинг (Resampling) — это процесс создания нового набора данных из имеющегося исходного набора. В численных методах он применяется для оценки статистических характеристик (доверительные интервалы, стандартная ошибка, p-значения), проверки гипотез, а также для балансировки классов в машинном обучении.
- Бустрап (Bootstrap) — это метод ресемплинга с возвратом (sampling with replacement). Идея состоит в том, чтобы многократно извлекать случайные выборки того же размера, что и исходная, из исходных данных, заменяя выбранные элементы обратно в генерацию выборки. Применение: Оценка дисперсии, медианы, корреляции, построение доверительных интервалов, когда распределение данных неизвестно или асимметрично.
- Перестановочный тест (Permutation Test) — используется для проверки гипотез (в частности, null-гипотезы о независимости или равенстве средних), перемешивая метки или значения данных. Применение: Проверка значимости различий между двумя группами (аналог t-теста, но без допущений о нормальности).
Существуют другие виды численного ресемплинга, но они относятся к машинному обучению.