 Юрий Летков
В ПО полиграфа «Диана» есть кнопки переключения с алгоритма ChanceCalc на... Стьюдент... При этом об алгоритме «Стьюдент» от разработчиков и правообладателей «Дианы» ни слышать, ни читать не приходилось. А вот читать о рекомендации разработчиков использовать Стьюдента в случае заключений для суда приходилось. И, конечно же, возникает вопрос: почему? Если в своё время разработчики ПО «Диана» часто говорили о ChanceCalc, хотя и не раскрывая его сути, то «Стьюдент» представляет полную неизвестность. Нет, фамилия, а точнее псевдоним Уильяма Сили Госсета хорошо известен науке. Известны и статистические техники его имени, без которых не обходится львиная доля научных исследований. Но каким образом его работы представлены в «Диане» неизвестно. T-распределение (распределение Стьюдента), статистический t-тест? Они работают при нажатии кнопки «Стьюдент»? Но каким образом? Чтобы как-то попытаться это понять, надо вспомнить, что представляют из себя t-понятия.
Распределение Стьюдента, или t-распределение, — это непрерывное вероятностное распределение, которое возникает при оценке среднего значения генеральной совокупности по малой выборке, когда истинная дисперсия неизвестна и оценивается по самой выборке.
Распределение Стьюдента используется в задачах:
- проверки гипотез о среднем;
- построения доверительных интервалов;
- анализа малых выборок;
- регрессионного анализа;
- дисперсионного анализа;
Главное условие применения t-распределения — неизвестная дисперсия генеральной совокупности. Если бы мы знали σ точно, мы могли бы использовать нормальное распределение (z-статистику). Но на практике мы знаем только выборочную дисперсию, которая сама по себе является случайной величиной. Распределение Стьюдента учитывает эту дополнительную неопределенность, давая более широкие интервалы и более консервативные (осторожные) выводы, особенно на малых выборках.
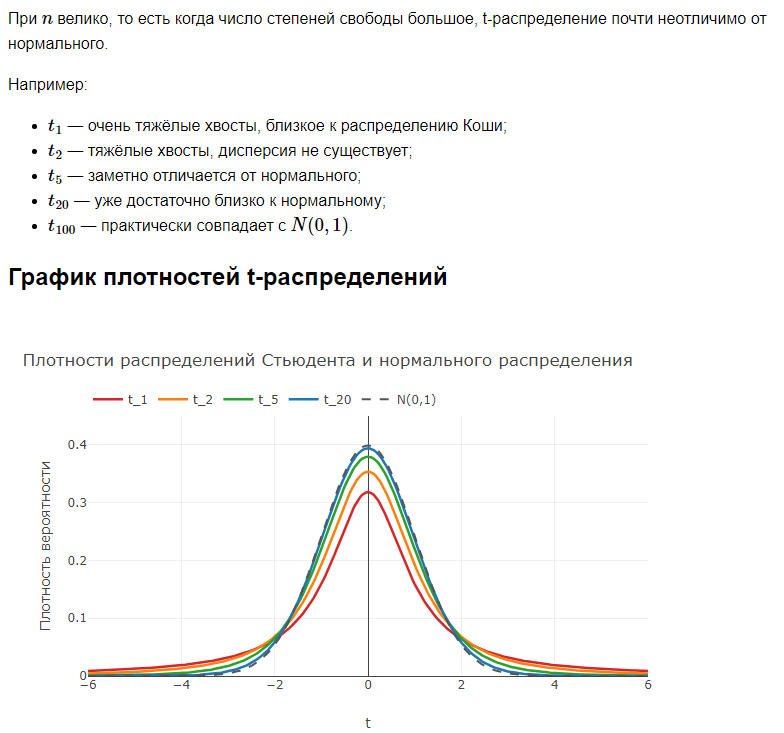
Важное примечание: с ростом числа степеней свободы (объема выборки) распределение Стьюдента быстро приближается к нормальному. При n > 30–100 различия становятся незначительными.
Какая из выше перечисленных задач решается в Диане кнопкой «Стьюдент»? Ответа нет, или он лично мне неизвестен.
t-тест — это параметрический статистический тест для проверки гипотез о среднем значении одной или нескольких выборок. Он основан на том, что при выполнении ряда условий t-статистика имеет распределение Стьюдента.
t-тест корректен, если выполняются основные условия:
-
Масштаб данных
Данные должны быть хотя бы интервальными: числовые, со смыслом разностей. -
Независимость наблюдений
Наблюдения не должны влиять друг на друга.
Для парного t-теста независимыми считаются пары наблюдений, а не сами «до» и «после» внутри пары. -
Нормальность
Данные или разности данных должны быть приблизительно нормальны.
Для больших выборок t-тест устойчив к отклонениям от нормальности благодаря центральной предельной теореме. -
Дисперсионная гомогенность
Для классического t-теста двух независимых выборок предполагается, что дисперсии в группах близки.
Если это условие не выполняется, лучше использовать модификацию Уэлча. -
Отсутствие сильных выбросов
Выбросы сильно влияют на среднее и дисперсию, поэтому могут исказить результат.
Сразу имеем, что при анализе теста мы имеем дело с маленькими выборками. Даже если тест типа ЮТА с 3Пв и 3Пв, то при 5 повторах выборка Пв всего 15 элементов, столько же и выборка Кв. А при 3 повторах всего по 9 элементов. В этих условиях определяющую роль корректности применения t-теста играет нормальность распределения метрических данных полиграфного теста. Кроме того, необходимо проводить проверку на равенство дисперсий. Проверку на выбросы. И, кроме того, мы тут имеем множественные сравнения. Ведь у нас три-четыре физиологических канала. Это значит, у нас три-четыре пар выборок Пв и Кв, средние которых необходимо сравнить.
Давайте вспомним ещё важные сведения о t-тесте, тем более, что многие из них относятся к и к любым другим статистическим тестам. А нам это пригодится, чтобы понять, как работает «Сокол 2».
Существует несколько видов t-теста, но нас интересуют два из них:
- t-тест для двух независимых выборок. Используется, когда нужно сравнить средние двух независимых групп.
- Односторонний и двусторонний t-тест.
Общая идея:
Мы проверяем нулевую гипотезу Н0 гипотезу против альтернативной гипотезы Н1. Гипотеза о равенстве средних мю - среднее одной группы. мю_0 - среднее второй группы.
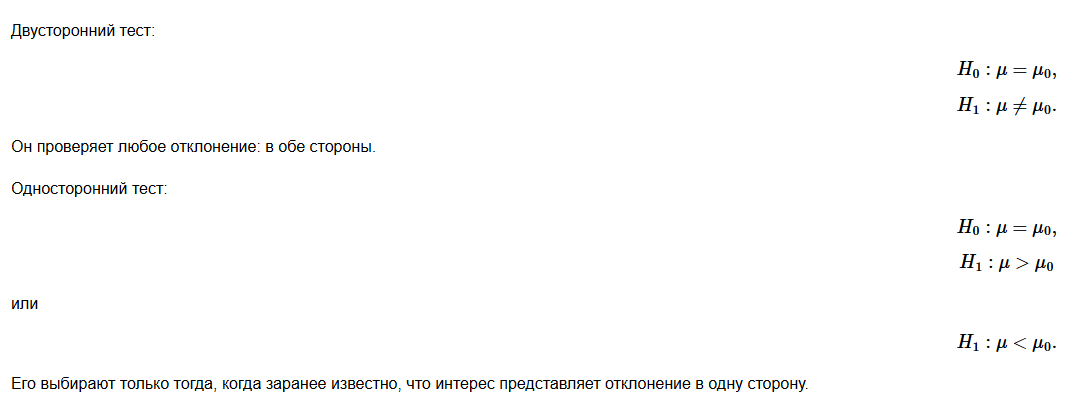
А нас интересует, на какой тип вопросов сильнее реагирует проверяемый: на Пв или Вс (Кв). А как это определить, имея на руках метрические данные? Например, вычислить средние и сравнить. Но так как мы имеем дело со статистикой, то надо провести тест, с помощью которого проверить гипотезы: Пв > Кв или Пв < Кв. Надо заметить, что это не единственные способ сравнения. Есть и другие. И даже результат может отличаться от выбранного способа. Но так устроена природа, что единственно верного способа сравнения не существует.
Как принимают решение
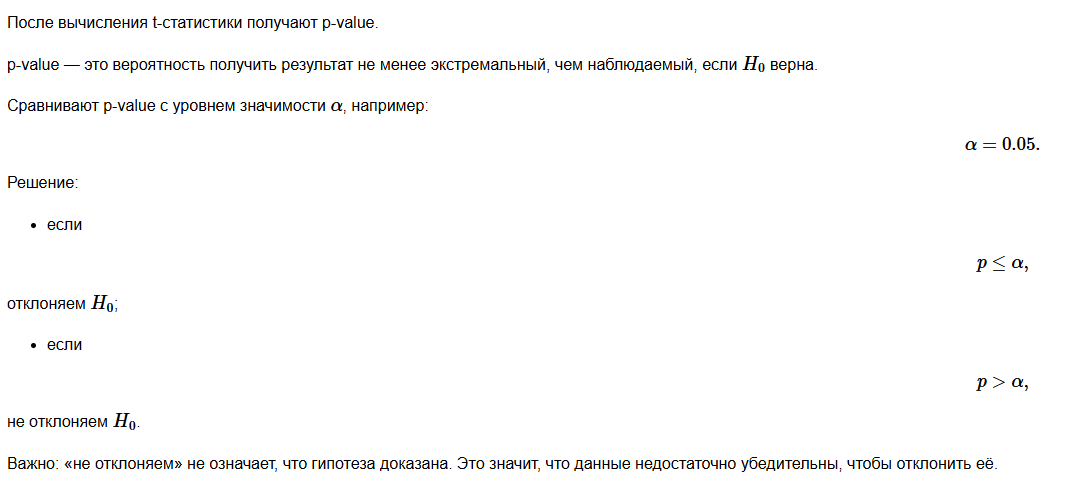
Общая схема t-теста (и других статист. тестов)
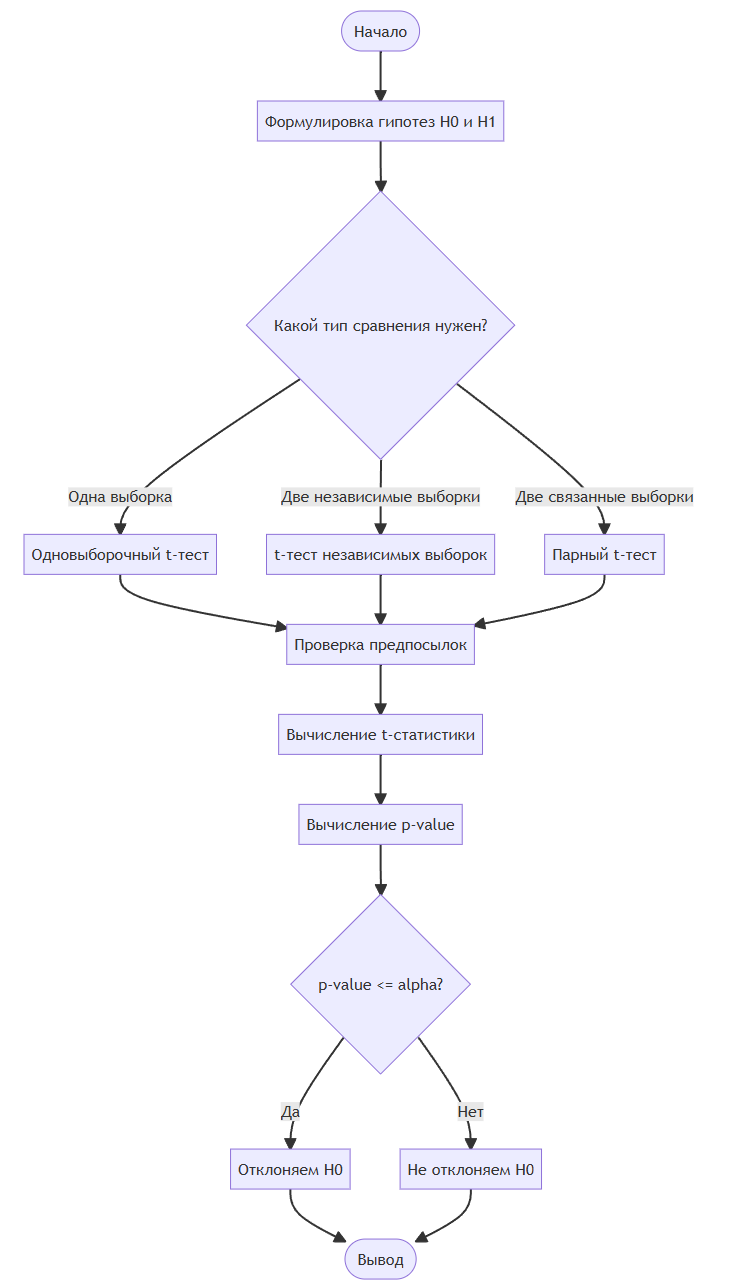
Важные нюансы, из-за которых применение t-теста становится либо некорректным, либо затруднительным:
- Если данных мало, например меньше 10–15 замеров, и данные сильно асимметричны или содержат выбросы, t-тест может дать ненадёжный результат.
То есть, перед использованием t-теста мы должны проверять данные на ассиметрию (нормальность) и выбросы.
- Если сравниваются две независимые группы, а их дисперсии сильно различаются, классический t-тест с объединённой дисперсией может быть некорректен.
Мы должны проверять данные на равенство дисперсий (ещё один стат. тест), или же использовать t-тест Уэлча.
- Если проводится много t-тестов подряд, возрастает вероятность случайной значимости. Например, если сравнить 20 групп попарно, даже при полном отсутствии реальных эффектов некоторые пары могут оказаться «значимыми» просто из-за случайности. В таких случаях применяют поправки на множественные сравнения: Бонферрони, Холма, Бехеллера и другие.
А при анализе полиграмм, при сравнении средних, мы делаем множественные сравнения. У нас три-четыре пары групп данных для сравнения - по числу используемых физиологических каналов. Если мы используем t- тест, мы должны использовать поправку, например, Бонферонни (как самую простую). Относительно этой поправки надо сказать, что она существенно снижает мощность теста.
Давайте теперь зададимся вопросом: а делается ли в ПО «Диана» что-либо из перечисленного выше? Единственное, что мы можем увидеть, это вот что:
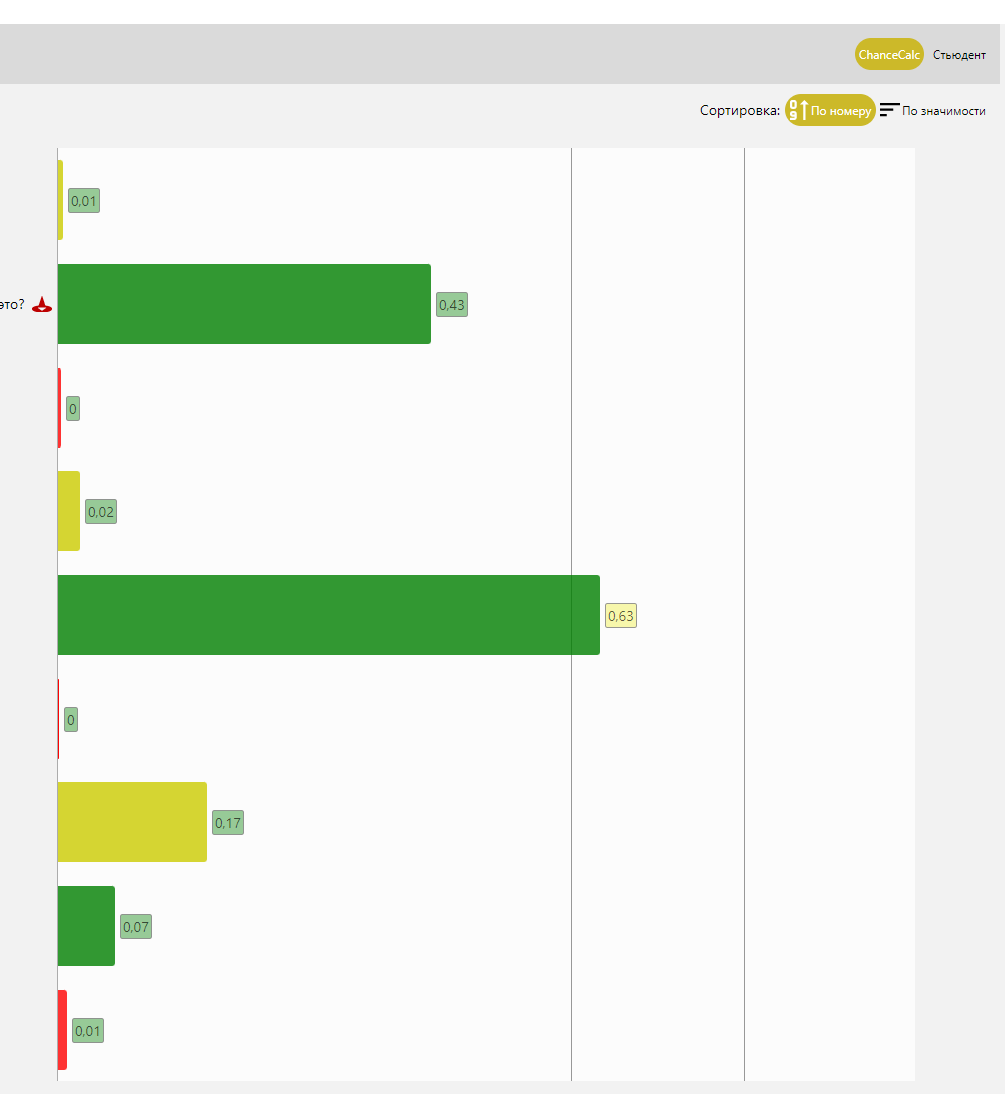
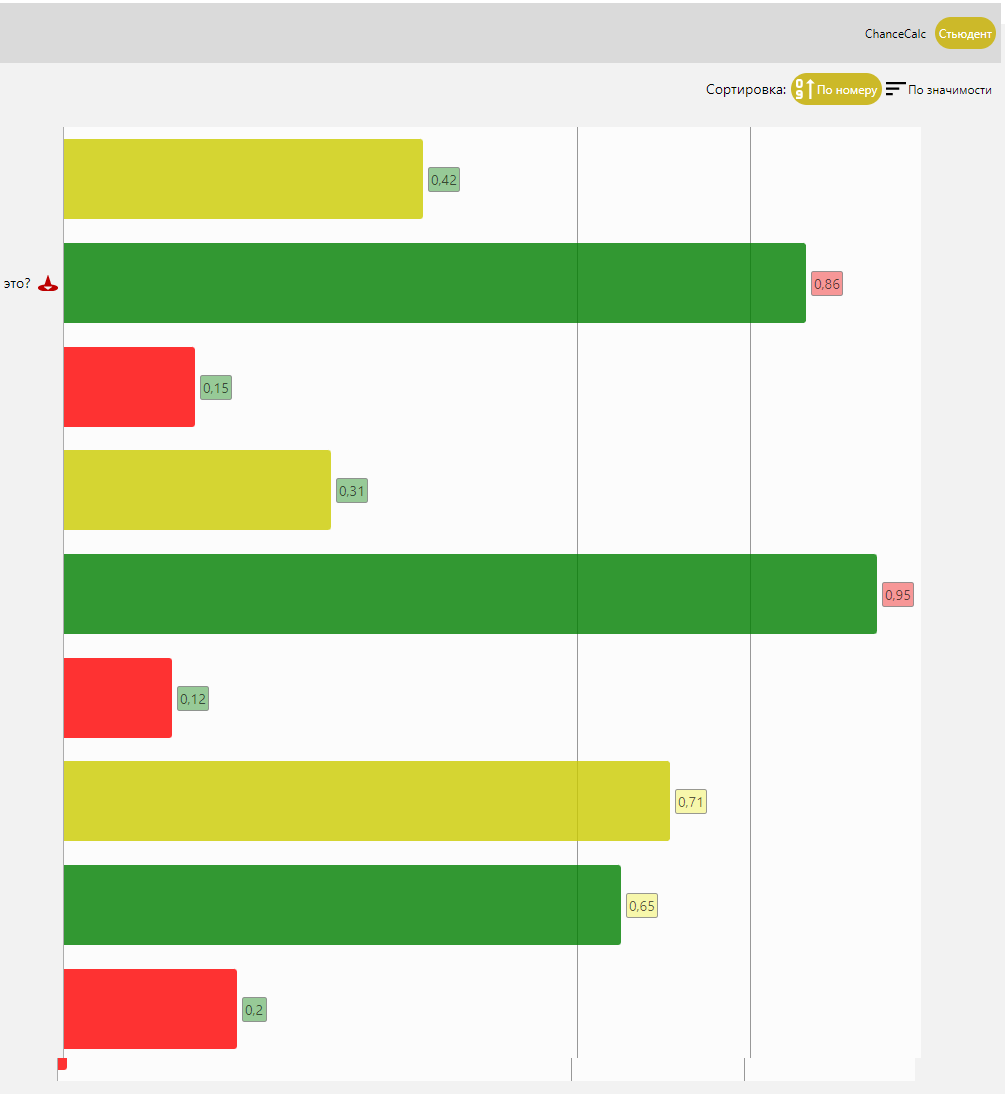
Слева нажата кнопка ChanceCalc, а справа «Стьюдент». Единственное, что мы видим, так это то, что меняются размеры столбиков и числа перед ними. Как это соотносится с написанным выше, абсолютно не понятно. И поэтому непонятно, почему кнопка «Стьюдент» — это для суда.
Как-то вёл беседу с одним полиграфологом, который сказал, что раз «Стьюдент», то это значит, что всё научно. Из аргументов только наличие псевдонима математика, внёсшего неоценимый вклад в статистику. Согласитесь, как-то слабовато для серьёзной аргументации. А между тем для экспертного заключения, предназначенного для суда, существуют строго определенные критерии. Некоторые из которых, имеющие к оценке полиграмм, я тут приведу:
-
Научная и практическая обоснованность. Исследование должно опираться на общепринятые научные и практические данные. Эксперт применяет методы и методики, которые признаны в профессиональном сообществе и позволяют получить достоверные результаты.
-
Проверяемость. Из текста заключения должно быть понятно, какие объекты и методы исследовались, какие данные получены и почему вывод логически следует из этих данных. Это позволяет другим специалистам (в том числе суду при оценке) воспроизвести ход исследования и убедиться в обоснованности выводов.
Наверное, есть и ещё требования, под котрые попадает экспертная оценка полиграмм, но достаточно и этих двух.
Надеюсь, совершенно понятно, что нажатие на кнопку «Стьюдент» (что происходит под капотом, мы просто не знаем) не является общепринятым научным методом. И как и почему из этого действия эксперт делает те выводы, которые он сделал в заключении, не соотвествует критерию проверяемости.
Информации на читателя обрушилось много. На сегодня думаю достаточно. В следующий раз перейдём уже ближе к нашим данным, их анализу и построению экспертного алгоритма оценки полиграмм.