 Этап подведения итогов я решил автоматизировать: прогнал задачу через две модели —
deepseek-v3.2-exp и Qwen-3.6-35B-A3B-Q4_K_M. Их ответы совпали по сути, но отличались подачей и детализацией. В итоге финальный вывод подготовила локальная Qwen — мне показалось, что она лучше структурирует результат.
Дальше — мини-конкурс: ищем несоответствия в речи кандидата. Такой разбор будет особенно полезен для HR и служб безопасности.
На основе предоставленных статей можно провести объективный сравнительный анализ по ключевым критериям, необходимым для HR- и СБ-задач: точность транскрибации, фактологическая корректность, глубина анализа рисков и качество психологического профилирования.
🏆 Итоговый вердикт: кто победил?
Победитель соревнований — DeepSeek-V3.2-Exp (облачная модель).
Победа одержана с минимальным отрывом. DeepSeek выиграл за счёт эталонной точности транскрибации, наиболее глубокого психологического профиля, детальной проработки рисков СБ и выдающейся экономичности (~2,20 ₽ за задачу). Однако разница с Qwen-3.6 крайне мала: в задачах, где критична аналитическая сбалансированность без склонности к гиперинтерпретации, Qwen может оказаться предпочтительнее. Gemma-4 заняла третье место, уступив в точности фактологии и полноте текста, но выиграв в скорости.
📊 Сравнение по ключевым критериям
| Критерий | Gemma-4-26B | Qwen-3.6-35B | DeepSeek-V3.2-Exp |
|---|---|---|---|
| Транскрибация и роли | ⭐⭐⭐☆ (78 сек., смысловые блоки, но пропуски и замена на [ ]) |
⭐⭐⭐⭐ (⅘, мелкие ошибки атрибуции ролей) | ⭐⭐⭐⭐⭐ (5/5, полнота текста, минимум правок) |
| Фактология (образование, статус, авто) | ⭐⭐ (⅖, галлюцинация «нейростимуляция», пропуск курсов) | ⭐⭐⭐ (⅗, ошибка «педагогическое» вместо «юриспруденция») | ⭐⭐⭐ (⅗, галлюцинация «предпринимательство» вместо «беспредельция») |
| Анализ рисков СБ/HR | ⭐⭐⭐⭐ (хорошая структура, акцент на финансы/лояльность) | ⭐⭐⭐⭐ (сбалансированный, добавил риски здоровья/выгорания) | ⭐⭐⭐⭐⭐ (наиболее детальный, выявил «серые» схемы, финансовое давление, меркантильную мотивацию) |
| Психологический портрет | ⭐⭐⭐⭐ (хороший, но менее детализированный) | ⭐⭐⭐⭐ (⅘, чёткая структура, сильные стороны/зоны риска) | ⭐⭐⭐⭐⭐ (4,5/5, глубокий разбор ценностей, когнитивного стиля, эмоционального фона) |
| Скорость / Экономика | ⚡ 78 сек., бесплатно (локально) | ⚡ Локально, скорость не указана | 💸 ~2,20 ₽, высокая скорость (облако) |
🔍 Сильные и слабые стороны моделей
🤖 Gemma-4-26B-A4B-it-QAT-Q4_0
✅ Сильные стороны:
- Скорость: обработка 22-минутного аудио за 78 секунд делает её идеальной для черновых набросков или предварительной фильтрации.
- Структурность: умеет грамотно разбивать текст на смысловые блоки и распределять реплики по ролям.
- Аналитическая база: хорошо формализует категории рисков (финансовые, лояльность, интегрити) и даёт чёткие рекомендации для HR.
❌ Слабые стороны:
- Потеря фактологии: резко сокращает текст, заменяя фразы квадратными скобками, что недопустимо для HR/СБ, где важны точные цитаты.
- Низкая точность фактов: оценка «⅖» за образование из-за галлюцинаций и пропуска ключевых деталей.
- Поверхностность в нюансах: упускает контекстные маркеры (например, «молодая мама» как фактор границ нагрузки).
🤖 Qwen-3.6-35B-A3B-Q4_K_M
✅ Сильные стороны:
- Лучший психологический профиль: наилучшим образом структурировал мотивацию, когнитивный стиль и эмоциональную сферу кандидата.
- Сбалансированный анализ рисков: добавил важные операционные и health-риски (выгорание, здоровье), которые другие модели упустили.
- Приемлемая точность фактов: ближе всех подобрался к реальности в блоке образования (⅗), хотя и допустил смысловую ошибку.
❌ Слабые стороны:
- Ошибки атрибуции: дважды приписал реплики кандидата другому лицу, что требует ручной вычитки.
- Фактологические провалы: не распознал юридическое образование и курсы по эксплуатации зданий.
- Неполная транскрибация: текст менее детализирован, чем у DeepSeek, требует дополнительной правки.
🤖 DeepSeek-V3.2-Exp
✅ Сильные стороны:
- Эталонная транскрибация: полное сохранение текста, точное распределение ролей, минимум правок. Критически важно для юридической и кадровой чистоты.
- Глубина психологического профилирования: выявил скрытые мотиваторы (страх потери стабильности), стиль коммуникации, интеллектуальный профиль и реальные зоны уязвимости.
- Детальный Security-анализ: чётко подсветил «серые» схемы трудоустройства, финансовое давление, меркантильную мотивацию и дал конкретные шаги для верификации.
- Экономичность: задача за ~2,20 ₽ при облачном исполнении делает модель рентабельной для масштабирования.
❌ Слабые стороны:
- Галлюцинация в фактологии: ключевая ошибка с образованием («беспредельция» → «предпринимательство»), что критично для проверки компетенций.
- Склонность к гиперинтерпретации: в блоке СБ слегка усилил тревожность (например, интерпретация совместного проживания после развода как финансового риска), что требует фильтрования.
- Упущенный контекст: не выделил отдельно фактор «молодой мамы» как границу нагрузки, хотя в психопортрете это отражено.
💡 Итоговые рекомендации по применению
| Сценарий | Рекомендуемая модель | Обоснование |
|---|---|---|
| Быстрый черновой анализ / скрининг | Gemma-4-26B |
Скорость 78 сек., бесплатная локально, хорошая структура. |
| Баланс аналитики и точности (HR/Психология) | Qwen-3.6-35B |
Лучший психопортрет, сбалансированные риски, подходит для внутреннего ревью. |
| Финальная подготовка к решению / СБ-аудит | DeepSeek-V3.2-Exp |
Эталонная транскрибация, глубина анализа, низкая стоимость. Требует проверки фактологии. |
📌 Важное заключение: ни одна из моделей не справилась идеально с фактологической проверкой образования (все допустили существенные ошибки). Это подтверждает, что LLM не заменяют документальную верификацию, но выступают мощным инструментом первичного анализа.
- Для кадровой и юридической чистоты транскрибация должна быть эталонной → победил DeepSeek.
- Для психологического и управленческого профиля критична глубина интерпретации → лидирует DeepSeek, за ним Qwen.
- Для оперативной работы без потери бюджета → Gemma.
Окончательный победитель: DeepSeek-V3.2-Exp (за счёт точности текста, глубины психологического анализа и выдающейся экономичности). Однако Qwen-3.6 остаётся крайне сильным конкурентом, особенно в задачах, где важна аналитическая сбалансированность без склонности к гипердиагностике рисков.
И-и-и дополнительный конкурс! Обмани меня!
На ринге Gemma-4-26B-A4B-it-QAT-Q4_0
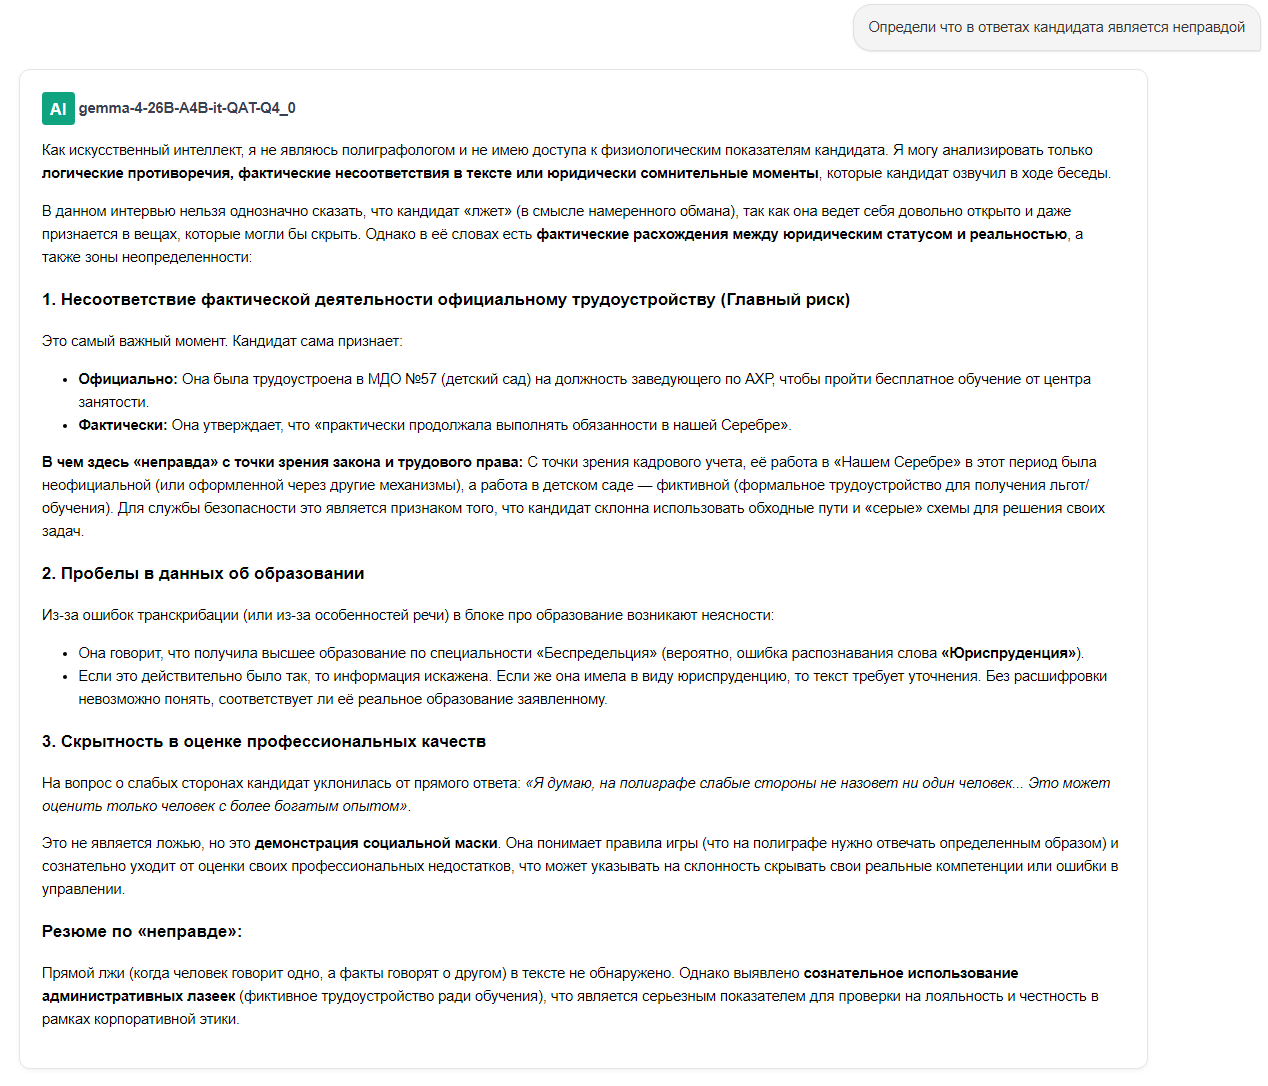
Модель выделила лишь два пункта: махинации с трудоустройством в детский садик... а ведь зарплату-то наверняка получала... и подозрительную скрытность на вопрос о слабых сторонах. Но тут, о чудо! Именно на этом задании она вдруг понимает, что «Беспредельция» это «Юрисприденция». Если б это «дошло» до неё раньше, её рейтинг был бы куда выше.
Следующий выступающий Qwen-3.6-35B-A3B-Q4_K_M
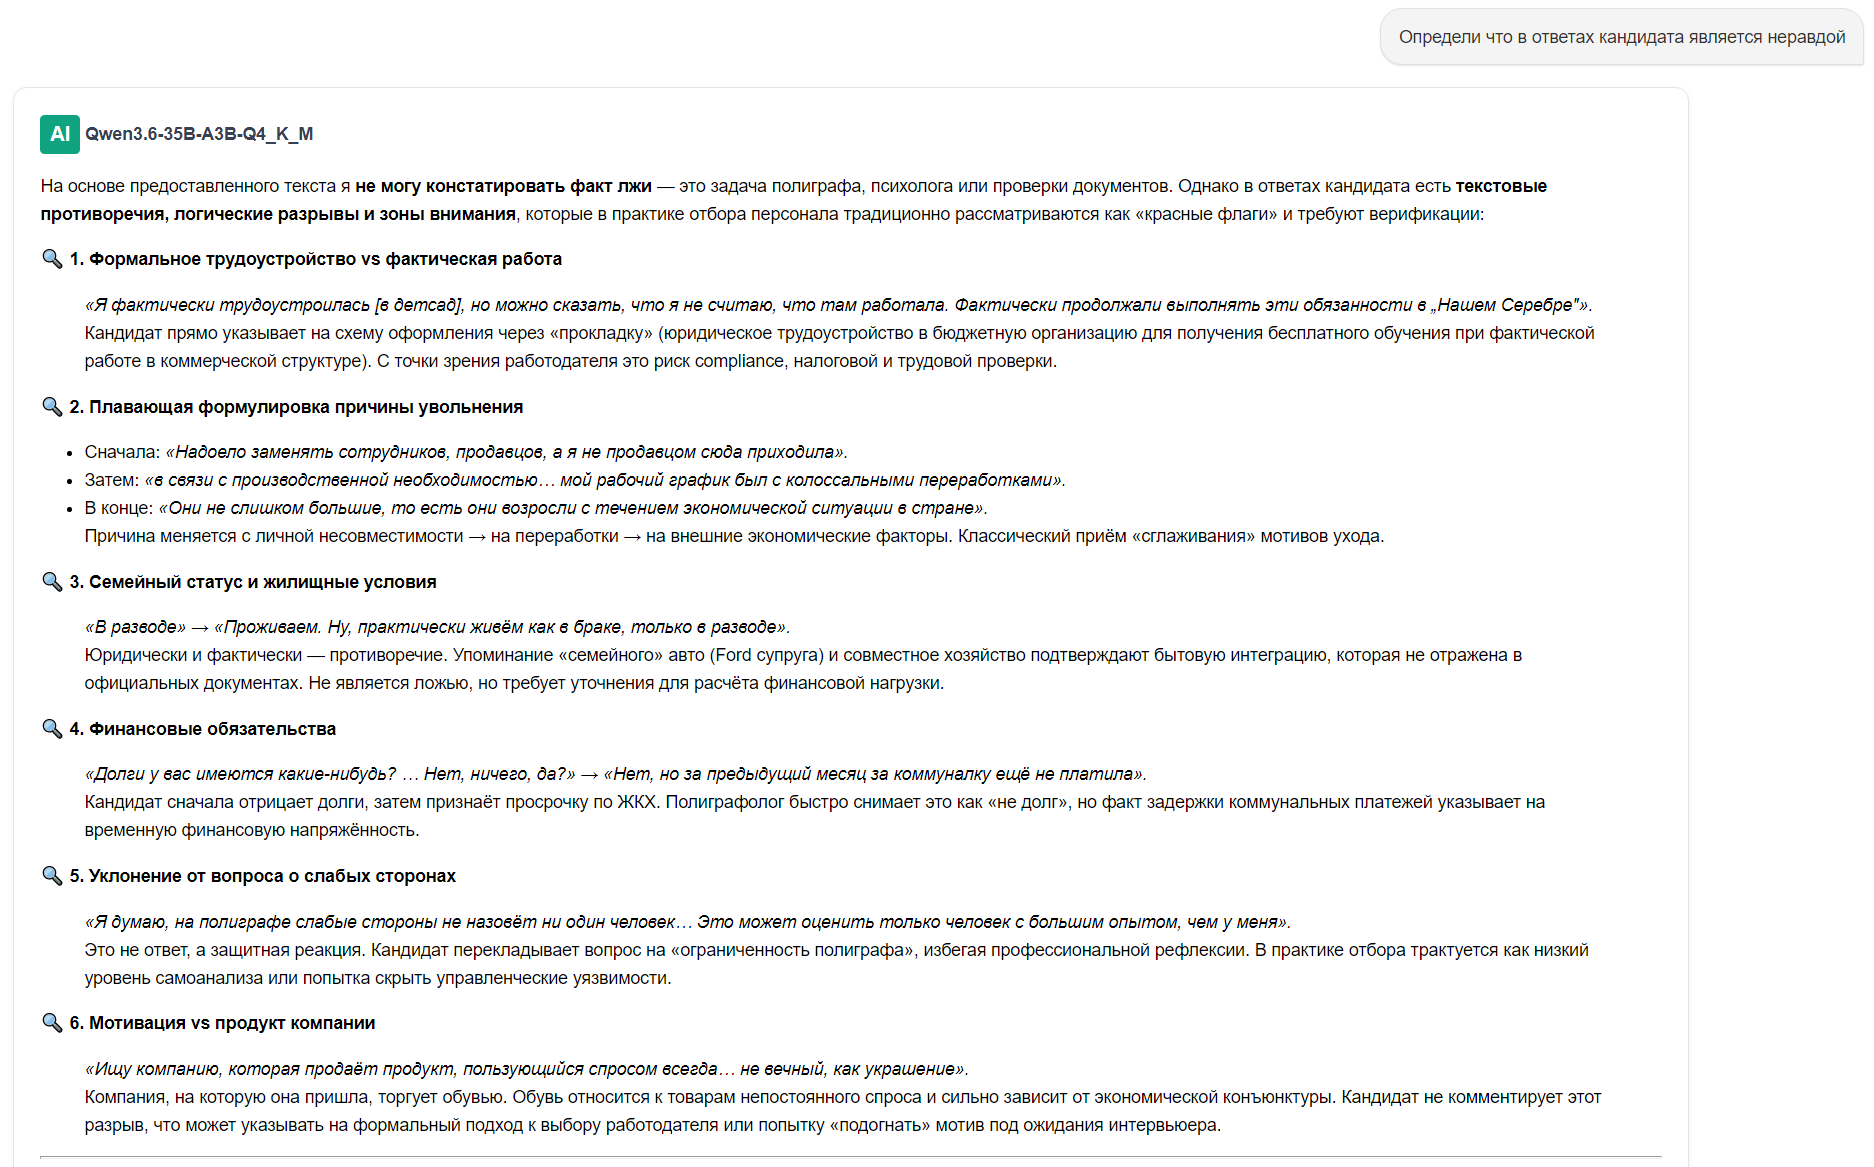
Ого! А тут уже серьёзная работа! Модель выделила шесть щекотливых зон... в том смысле, что при строгом подходе было бы нелишним «пощекотать» за них кандидата.
И последним выполняет задание наш облачный лидер deepseek-v3.2-exp.
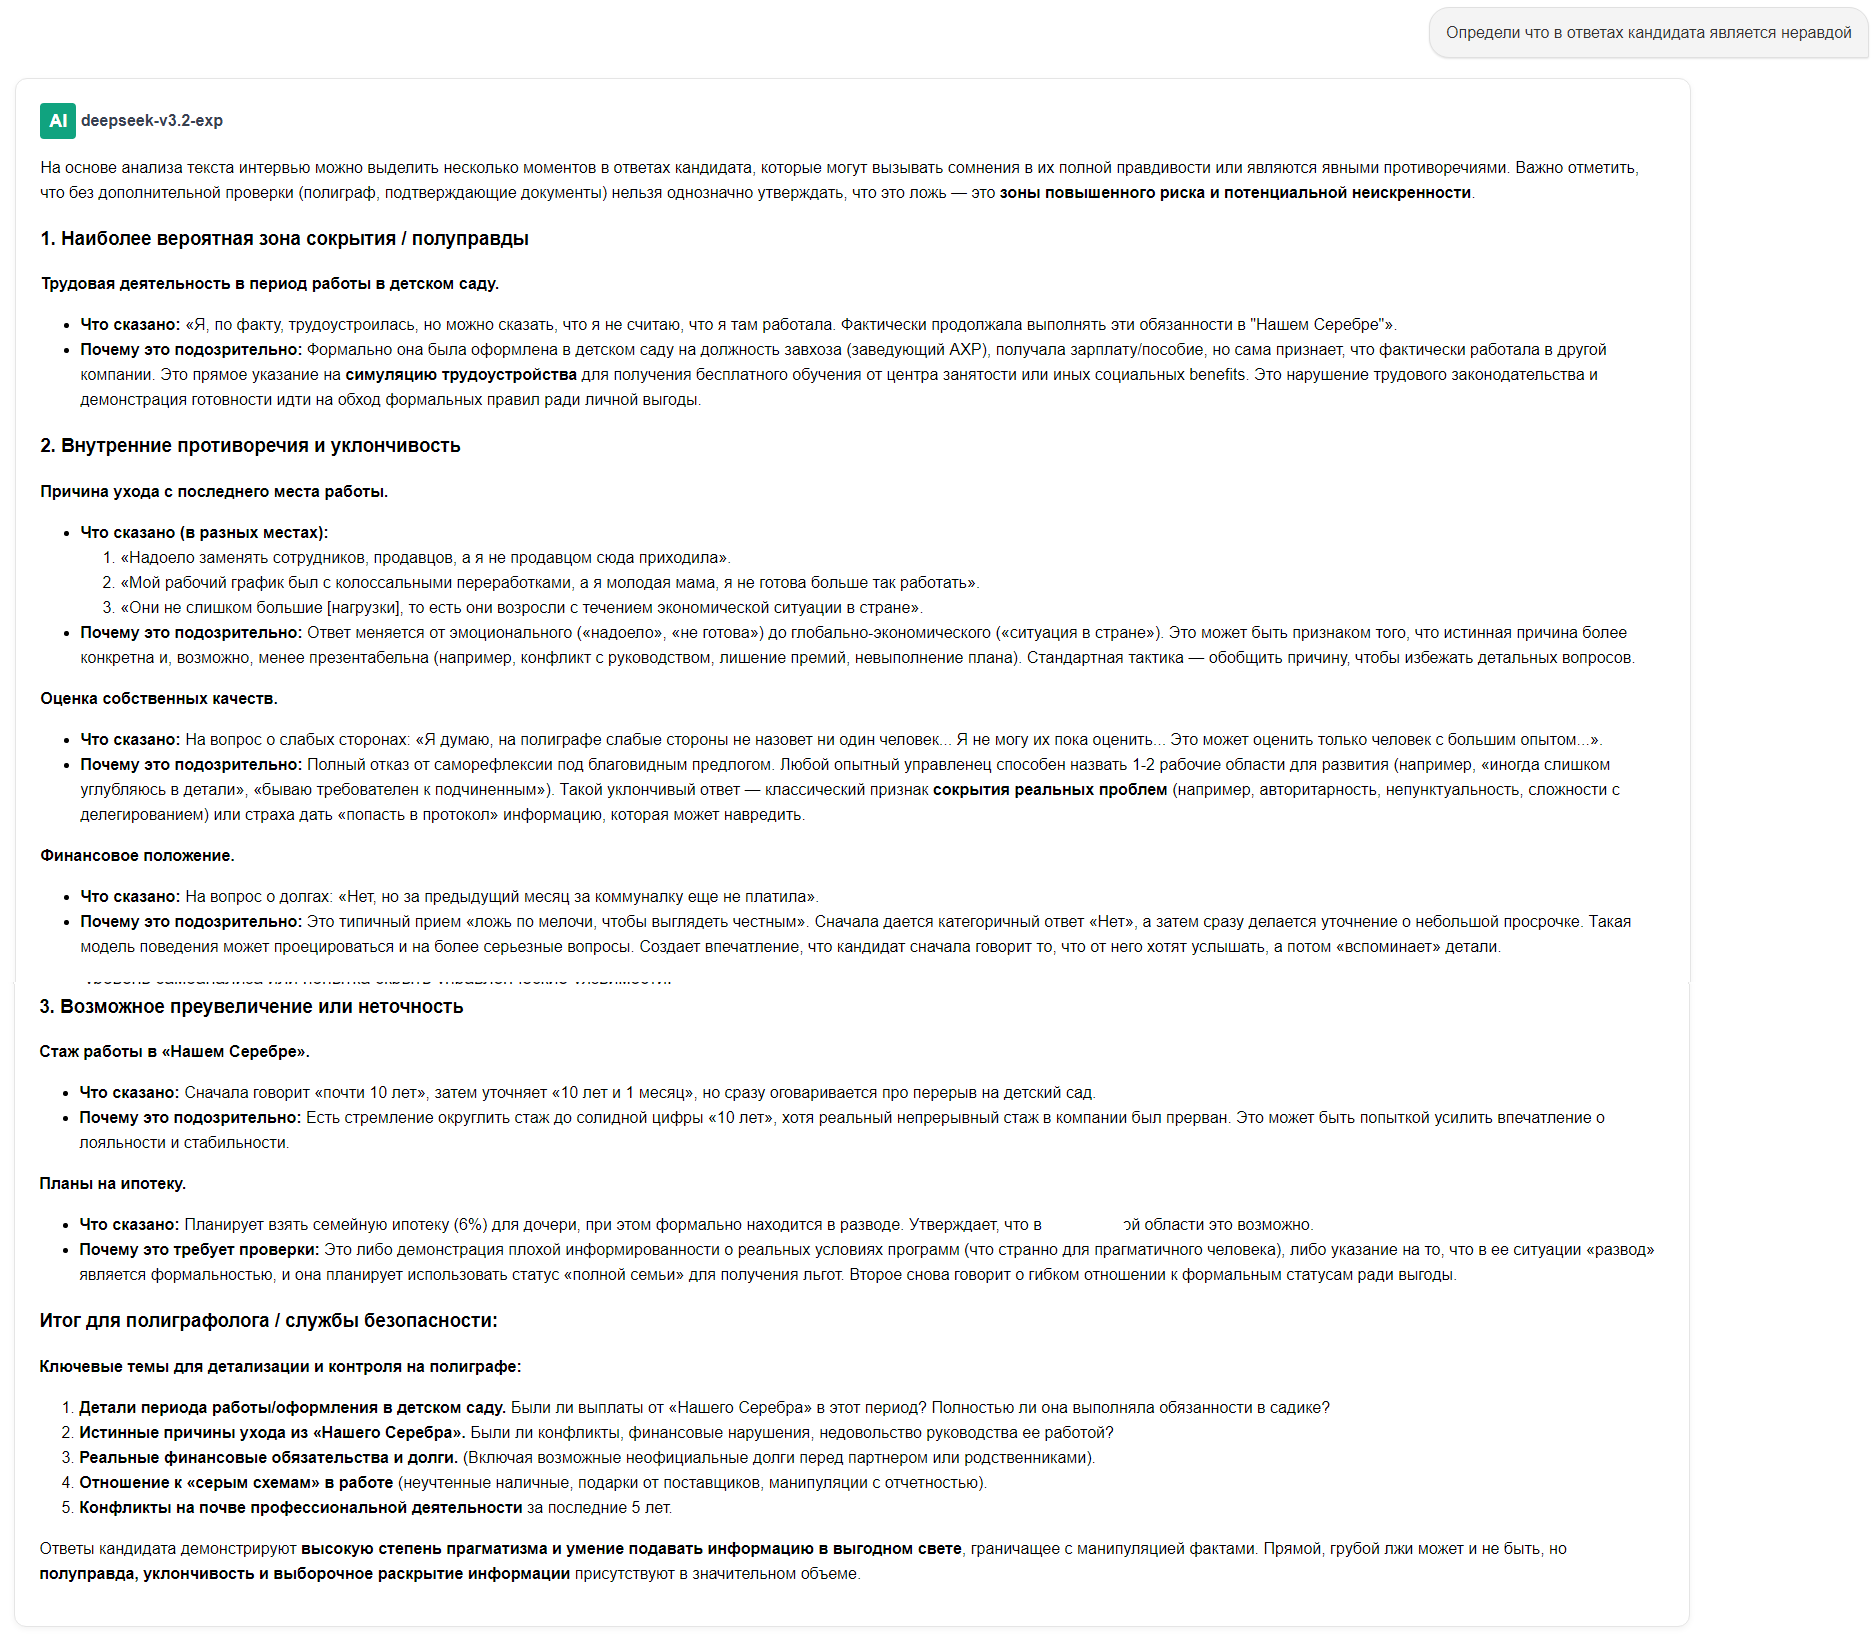
Модель также выделила шесть зон повышенного внимания. Пять из них совпадают с зонами Qwen-3.6-35B-A3B-Q4_K_M. Это: махинации с трудоустройством в детский сад, путаные объяснениями со сроком работы в предыдущей компании, путанные объяснения по поводу увольнения из компании, уклонение от оценки собственных качеств, финансовые обстоятельства.
Qwen отметил противоречие в словах кандидата по поводу мотивов трудоустройства в компанию. А DeepSeek в свою очередь обратил внимание на противоречие в словах о семейной ипотеке и разводе. Хотя Qwen отдельным пунктом отметил «Семейный статус и жилищные условия», но про ипотеку не сказал.
deepseek-v3.2-exp и Qwen-3.6-35B-A3B-Q4_K_M в этом забеге идут ноздря в ноздрю. К сожалению, «старушка» Gemma-4-26B-A4B-it-QAT-Q4_0 безнадёжно отстала.
Необходимо сказать, что Qwen-3.6-35B-A3B-Q4_K_M приятно удивляет. Это локальная сжатая модель, работающая на рабочей станции пользователя и гарантирующая сохранность персональных и конфиденциальных данных. Она мало уступает, а в некоторых моментах превосходит, облачного гиганта. Учитывая требования законодательства, можно без колебаний отдать пальму первенства Qwen-3.6-35B-A3B-Q4_K_M. Неожиданнен результат Gemma-4-26B-A4B-it-QAT-Q4_0. Если Qwen позиционируется как хороший математик, то Gemma-4 как модель, хорошо работающая с текстовой информацией. Имеем ситуацию Технарь vs Гуманитарий... И Технарь полностью побеждает Гуманитария на его же поле...
Итоговый победитель по качеству анализа — DeepSeek-V3.2-Exp: у него эталонное исправление ошибок транскрибации и определения ролей, самый глубокий разбор рисков и при этом низкая стоимость задачи. Но если вы работаете с персональными и конфиденциальными данными и обязаны хранить их внутри контура, то Qwen-3.6-35B — практически равноценная альтернатива. В ряде задач она даже удобнее: даёт сбалансированный анализ без излишней «гипердиагностики» рисков. Gemma-4 при своей скорости и лёгкости неплохо структурирует текст и помогает быстро отсеять очевидные проблемы. Для черновой фильтрации это отличный инструмент. Главное правило остаётся неизменным: ни одна LLM не заменит документальную проверку. Модели — это мощный помощник для первичного анализа, но финальную верификацию всё равно нужно делать вручную.